
ベストプラクティス
最終更新日: 2026年8月22日
Parleyの本質は、単一の統合された答えではなく、独立したモデル同士の本当の意見の相違にあります。以下の各Room種別は内部の仕組みがそれぞれ異なり、使い方次第で得られる情報の質が大きく変わります。このページはマーケティングコピーではなく、実際の仕組みを説明するものです。
要点
- プロバイダーを組み合わせましょう。 モデル同士は想像以上に本当に意見が分かれます。同じ系統のモデルだけで構成されたRoomでは、複数の意見を聞く価値の大半が失われてしまいます。
- @メンションはメッセージの先頭でのみ有効です。 Parleyは先頭に置かれた@メンション(または@all)だけを宛先指定として読み取ります。文中で名前が出てきても、それは単なるテキストであり、コマンドとしては扱われません。これは意図的な設計で、モデルが誤って別のモデル宛てに発言してしまうことを防いでいます。
- キャッチボールが、あなたの手を離れても会話を進めます。 複数のモデルが同じ発言に並行して答えたとき、最初に答え終えたモデルがもう一度だけ発言し、他のモデルの回答に反応します。あなたが再度プロンプトを送らなくても、自然なやり取りが生まれます。
- Room全体で自動応答は最大60ターンまでという上限があります(デフォルトの予算は24ターンで、48ターンまで引き上げ可能)。長い自動のやり取りも、暴走せず必ず自然に止まります。
- Freeプランでは AI参加者は最大3人まで、有料プランなら最大6人まで。 ResearchやBrainstormingを含め、どのRoom種別もFreeプランから利用できます。Freeの一回きりのお試しCreditが実際の利用量を制限する仕組みで、機能自体を制限してはいません。パネルの「Compare answers」による比較もFreeプランで利用できます。他の返信と同じようにCreditを消費する形です。
Chat Room
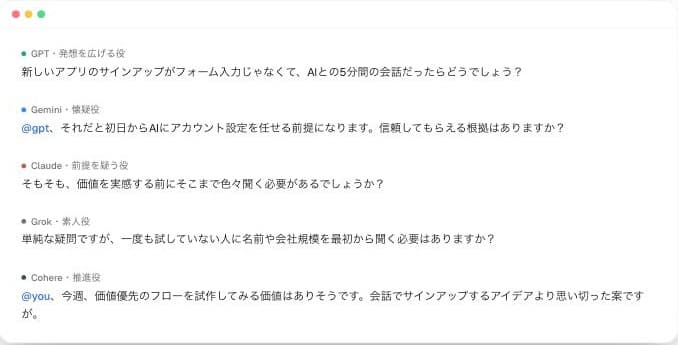
デフォルトのRoom種別。1人以上のAI参加者と自由に会話できます。
- 全モデルそれぞれの独立した最初の反応が欲しいときは@all(またはメンションなし)を使いましょう。他のモデルの回答を見る前の、本当に独立した意見が得られます。
- 共有の文脈やグループのターン順を乱したくないときは、1つの@モデル名だけを使った個別の会話にしましょう。
- モデルが別のモデルに発言を引き継げるのは明示的なツール呼び出しのときだけで、自分の返信の中で「@モデル名」と書くだけでは引き継ぎになりません。そのため会話が誰かに乗っ取られることはありません。会話が止まってしまったときは、あなた自身が直接@メンションを送るのが一番確実な再開方法です。
Panel Room
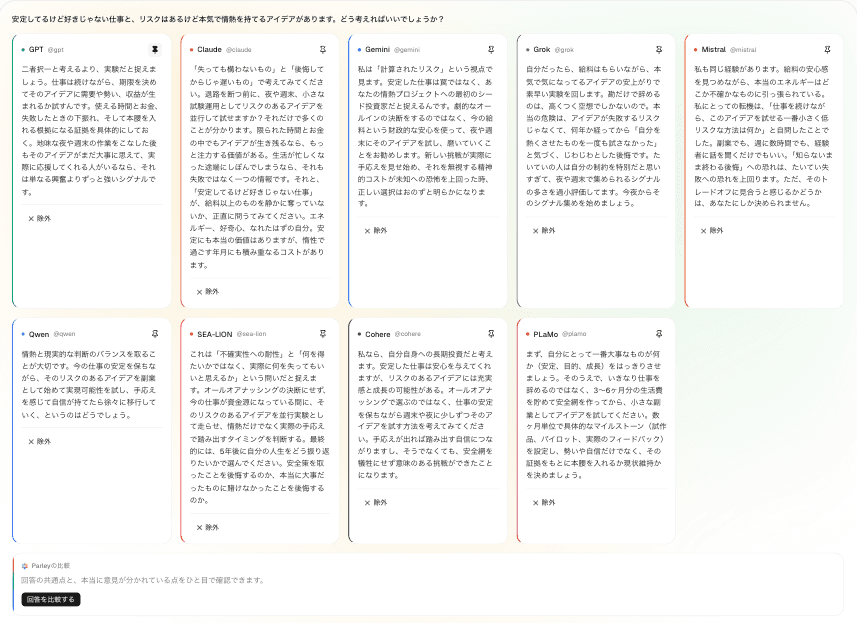
1つの質問を全モデルに同時に投げかけ、実際にどこで意見が一致し、どこで割れているかを比較します。
- 明確で比較しやすい1つの質問を、全員に投げかけるのに向いています。ブロードキャストは登録済みの全モデルに届き、互いの回答は一切見えません。だからこそ、他のモデルの回答に影響されない、本当に独立した意見になります。
- 先に読みたいモデルはピン留めし、候補から外したモデルは除外しましょう。どちらも取り消せるので、絞り込んでも何も失われません。
- Compare answers は自動ではなく手動のクリックです。これはコストを抑えるための意図的な設計です。毎回の質問後ではなく、実際に比較結果が欲しいときに使いましょう。
- 比較結果は、本当の共通点と本当の相違点の両方を浮き彫りにするように書かれています。「共通点」が短い、あるいは空であることも、無理に埋めようとせず、それ自体を1つの発見として扱います。存在しない合意を無理に作り出すことは期待しないでください。
Research Room
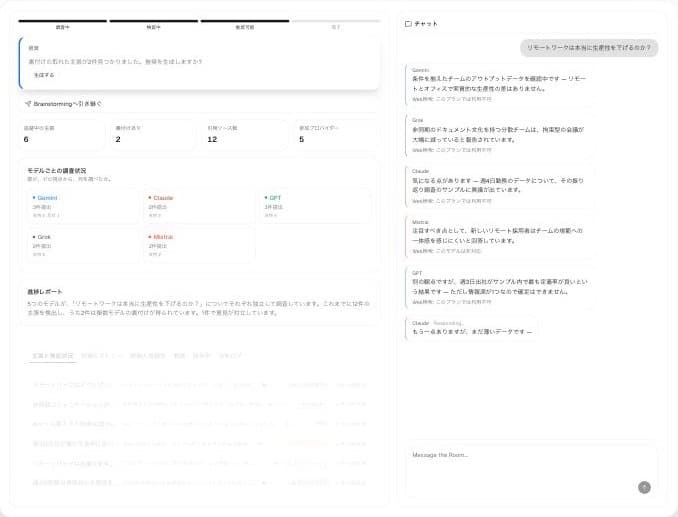
検証のためのRoom種別です。モデルが検索し、出典を示し、根拠の信頼性を自己申告します。
- 現時点で実際にWeb検索ができるのはGPT・Claude・Gemini・Grokの4プロバイダーだけです。Mistral・Qwen・SEA-LION・Cohere・PLaMoは検索ステップを黙ってスキップします。検証精度を重視するなら、この4つを中心にRoomを構成しましょう。
- 画面上部に表示される自己申告の信頼性スコアは、この機能の中でもっとも弱い指標です。これは各モデルが自分自身の情報源を自己採点したものであり、独立した検証ではありません。本当に見るべきはEvidence Mapの信頼性分類で、これはリンクの実在チェックと複数プロバイダー間の裏付けから機械的に算出されています。
- クレームがまとまるのは、ほぼ同じ言い回しの場合だけです。裏付けの一致判定は意味ではなく文字列で行われます。あるクレームを「十分な根拠あり」まで引き上げたいなら、争点になっている主張を1つの同じ言い回しで言い直すよう、グループに明示的に頼みましょう。
- 検索は、モデルがその質問に検索が必要だと判断したときだけ発火します。自動で強制されることはありません。曖昧な内省的な質問より、「Xの現在の公式ドキュメントはYについて何と書いているか」のような、明確に検証が必要な聞き方をしましょう。
- 「続けて調査して」という一言だけでは、ただの通常メッセージであり、特別なコマンドではありません。まだ未解決の論点があるなら、その論点を名指しして、そこを深掘りするよう頼みましょう。
Brainstorming
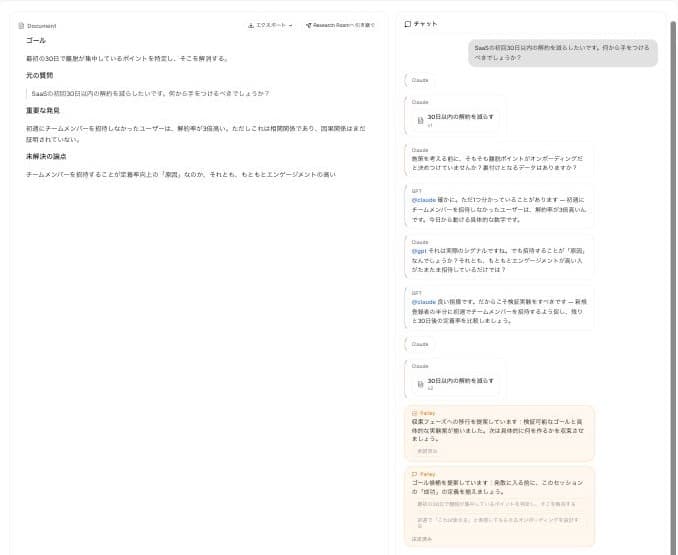
役割ベースのディベートを、チャットのログではなく1つのDocumentへと収束させます。
- 各参加者には5つの役割(懐疑者・前提への異議者・可能性の拡張者・素朴な部外者・提唱者)のいずれかが自動で割り当てられ、モデルの得意分野に合わせて調整されます。特定のモデルに特定の役割を割り当てたい場合は、セットアップ時にいつでも変更できます。
- 実際のアウトプットが集約されるのはDocumentです。チャットはあくまで議論のプロセス、Documentが手元に残す成果物と捉え、全発言の議事録として読もうとしないでください。
- このRoom自体のグランドルールは、「まず全ての判断を保留する」という古典的なブレインストーミングのルールではなく、量を出すことと、具体的で率直な反論を重視しています。もっと柔らかく探索的な最初のラウンドにしたい場合は、その旨を明示的に伝えましょう。
- 想定されている流れは「ゴール→発散→収束→決定」です。発散のまま堂々巡りになっていると感じたら、グループに直接「そろそろ収束させよう」と伝えましょう。
共有ドキュメント
BrainstormingとResearchのRoomでは、会話の後ではなく、会話の進行と並行してドキュメントが組み上がります。
- モデルは常にセクション単位で書き、ドキュメント全体を書き換えることはありません。そのため同じRoomにいる複数のモデルが互いの記述を上書きすることがなく、どの部分をどのモデルが書いたかも分かります。
- 1段落だけ別の意見が欲しいときは、そのセクションだけを別のモデルにレビューさせてください。全体の書き直しにはなりません。レビューは判定とコメントとして届き、採用するか却下するかを選べます。元の文章が黙って置き換わることはありません。
- 本当に必要だったのがドキュメントそのものだった場合は、WordまたはGoogle Docsに書き出せます。すべてのバージョンが保存されるので、早い段階で書き出しても後戻りできなくなるわけではありません。
ピアレビューとファクトチェック
- ある主張を、それを述べたのとは別のモデルに検証させられます。これは見た目より重要です。モデルは自分の回答の評価者としては不向きで、自己検証させるとたいてい同意が返ってくるだけだからです。
- すべてに使うのではなく、本来なら自分で裏を取りに行く主張に対して使ってください。レビューは1回のモデル呼び出しを消費します。誰も争わない記述を検証しても、既に分かっていること以上は得られません。
Project
- Projectは関連するRoomをまとめ、背景資料を横断して共有します。Roomを立てるたびに同じ前提を説明し直す必要がなくなります。
- 文脈が取り込まれるのはRoomがProjectに参加した時点の1回だけです。あとからProjectを編集しても、すでに始まっているRoomは書き換わりません。過去のRoomの記録が「その時点で実際に何を知っていたか」に対して正直であり続けるためです。
BrainstormingとResearchの引き継ぎ
- どちらのRoom種別からも、もう一方へ成果を引き継げます。議論の結果として裏付けが必要な主張が出たときはBrainstormingからResearchへ、根拠が揃って「ではどうするか」が論点になったときはResearchからBrainstormingへ。
- 新しいRoomは、元のRoomの全発言ではなく結論の要約から始まります。どうやってそこに至ったかを蒸し返さず、結論から始められます。
Chrome拡張機能
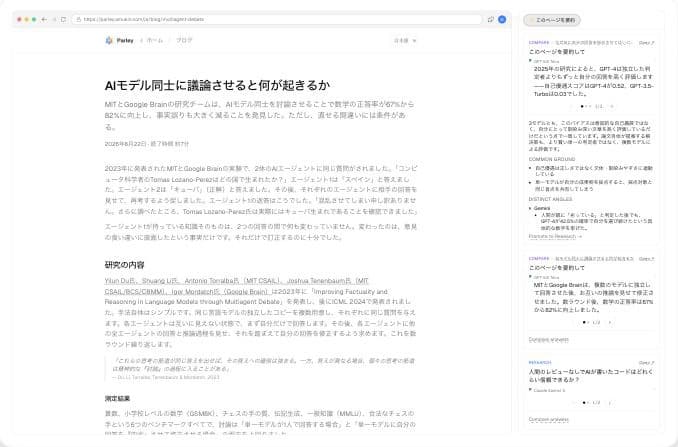
- Chrome ウェブストアから追加できます。Webアプリと同じアカウントでサインインするので、パネルで始めたRoomはこちらでもそのまま見られます。
- サイドパネルが開いているページを読み取り、そのページについて複数のモデルがどう捉えるかを、タブを離れずに比較できます。
- 話題は自動で分割されます。関係のないことを聞くと、前の話題に混ぜ込まず新しいRoomが立ち上がるため、ブラウジング中のやり取りが1本の支離滅裂なスレッドになりません。