
모범 사례
최종 수정일: 2026년 8월 22일
Parley의 핵심은 하나로 뭉뚱그린 답이 아니라, 독립된 모델들 사이의 진짜 의견 차이입니다. 아래 각 Room 유형은 내부적으로 서로 다른 방식으로 동작하며, 어떻게 사용하느냐에 따라 얻을 수 있는 실제 신호의 양이 달라집니다. 이 페이지는 마케팅 문구가 아니라 실제 작동 방식을 설명하므로, 각 기능을 최대한 활용하는 데 도움이 됩니다.
요약
- 프로바이더를 섞어서 사용하세요. 서로 다른 모델은 예상보다 훨씬 더 자주 의견이 갈립니다 — 하나의 프로바이더 계열 모델만으로 구성된 Room은 두 번째 의견이 주는 가치의 대부분을 잃게 됩니다.
- @멘션은 메시지 맨 앞에서만 동작합니다. Parley는 메시지 맨 앞에 오는 @멘션(또는 @all)만 대상 지정으로 인식합니다. 문장 중간에 이름이 등장해도 그것은 단순한 텍스트일 뿐, 명령으로 처리되지 않습니다. 이는 의도된 설계로, 한 모델이 다른 모델을 실수로 호출하는 것을 방지합니다.
- Catch-ball이 당신 없이도 대화를 이어갑니다. 여러 모델이 같은 브로드캐스트에 동시에 응답할 때, 가장 먼저 답변을 마친 모델이 한 번 더 발언 기회를 얻어 다른 모델들의 답변에 반응합니다 — 당신이 다시 프롬프트를 보내지 않아도 자연스러운 상호작용이 이어집니다.
- Room당 자동 응답에는 60턴이라는 확실한 상한이 있습니다(기본 예산은 24턴이며 최대 48턴까지 늘릴 수 있습니다). 긴 자동 대화도 폭주하지 않고 항상 스스로 멈춥니다.
- Free Room은 AI 참여자가 최대 3명, 유료 플랜은 최대 6명까지입니다. Research와 Brainstorming을 포함해 모든 Room 유형은 Free 플랜에서도 이용할 수 있습니다 — 실제 이용량을 제한하는 것은 Free의 1회 한정 체험 Credit이며, 기능 자체를 막지는 않습니다. 패널의 "Compare answers" 종합 비교도 Free 플랜에서 이용할 수 있으며, 다른 답변과 동일하게 Credit을 사용합니다.
Chat Room
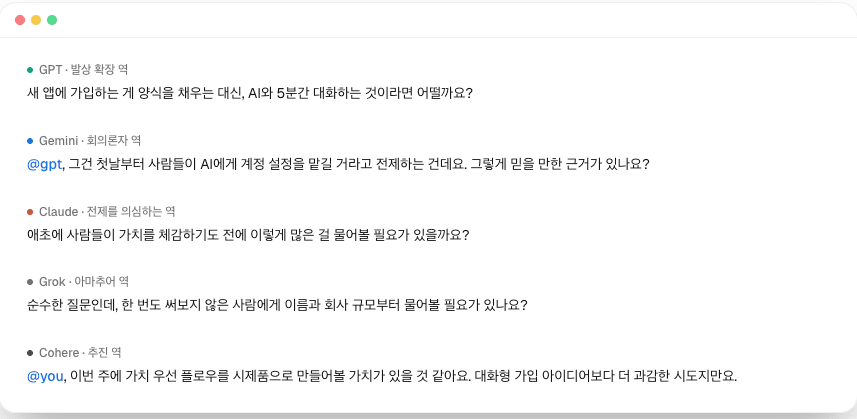
기본 Room 유형 — 하나 이상의 AI 참여자와 자유롭게 대화합니다.
- 모든 모델이 서로의 답변을 보기 전에 각자 독립적으로 첫 반응을 보이길 원할 때는 @all(또는 멘션 없이)을 사용하세요.
- 공유된 맥락이나 그룹의 발언 순서를 흐트러뜨리지 않는 개별 대화를 원할 때는 하나의 @모델명만 사용하세요.
- 모델이 다른 모델에게 대화를 넘길 수 있는 것은 명시적인 도구 호출을 통해서뿐이며, 자기 답변에 "@모델명"이라고 쓰는 것만으로는 넘겨지지 않습니다 — 그래서 어떤 모델이 인계를 흉내 내어 대화를 가로챌 수 없습니다. 대화가 멈춰 있다면, 당신이 직접 @멘션을 보내는 것이 항상 가장 확실한 재개 방법입니다.
Panel Room
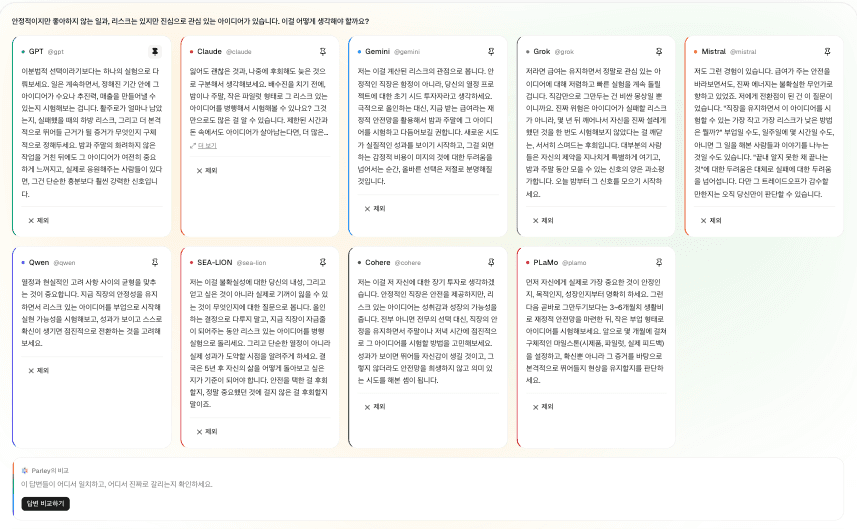
하나의 질문을 모든 모델에게 동시에 던진 뒤, 실제로 어디서 의견이 일치하고 어디서 갈리는지 비교합니다.
- 모두에게 보낼 명확하고 비교하기 쉬운 하나의 질문에 가장 잘 맞습니다 — 브로드캐스트는 등록된 모든 모델에게 전달되며 서로의 답변은 전혀 보이지 않으므로, 얻는 결과는 다른 답변에 영향받지 않은 진짜 독립적인 의견입니다.
- 먼저 읽고 싶은 모델은 고정하고, 제외하고 싶은 모델은 배제하세요 — 둘 다 되돌릴 수 있으므로 범위를 좁혀도 아무것도 잃지 않습니다.
- Compare answers는 자동이 아니라 수동 클릭입니다 — 이는 비용을 제어하기 위한 의도적인 설계입니다. 매 질문마다가 아니라, 실제로 종합 비교가 필요할 때 사용하세요.
- 이 종합 비교는 실제 공통점과 실제 차이점 모두를 드러내도록 작성됩니다 — "공통점" 항목이 짧거나 비어 있는 것도 억지로 메우려 하지 않고 하나의 진짜 발견으로 취급합니다. 존재하지 않는 합의를 억지로 만들어낼 것이라고 기대하지 마세요.
Research Room
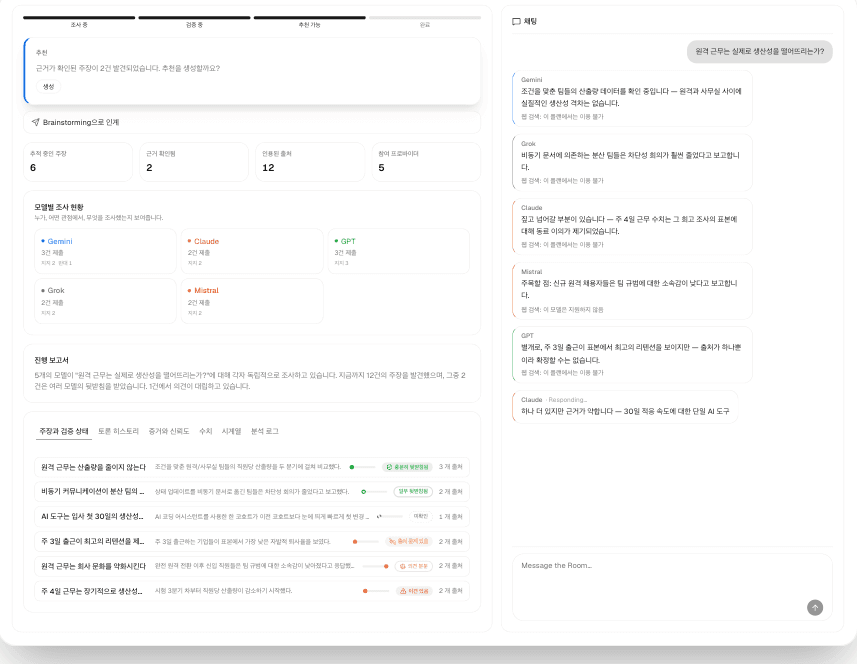
검증을 위해 설계된 Room — 모델이 검색하고, 출처를 인용하며, 근거의 신뢰도를 스스로 보고합니다.
- 현재 실제로 웹 검색이 가능한 프로바이더는 GPT, Claude, Gemini, Grok 4개뿐입니다. Mistral, Qwen, SEA-LION, Cohere, PLaMo는 검색 단계를 조용히 건너뜁니다. 검증이 중요하다면 이 네 프로바이더 중심으로 Room을 구성하세요.
- 화면 상단에 표시되는 자기 보고 신뢰도 점수는 이 기능 전체에서 가장 약한 신호입니다 — 각 모델이 자신의 출처를 스스로 채점한 것일 뿐, 독립적인 검증이 아닙니다. 진짜 신호는 Evidence Map의 신뢰도 분류입니다 — 이는 자동화된 링크 확인과 여러 프로바이더 간 교차 검증을 통해 계산됩니다.
- 주장(claim)은 표현이 거의 동일할 때만 하나로 묶입니다 — 근거 일치 여부는 의미가 아니라 텍스트로 판단됩니다. 특정 주장을 "충분히 뒷받침됨" 상태로 끌어올리고 싶다면, 쟁점이 되는 부분을 하나의 공통된 표현으로 다시 말해 달라고 그룹에 명시적으로 요청하세요.
- 검색은 모델이 해당 질문에 검색이 실제로 필요하다고 판단할 때만 실행됩니다 — 자동으로 강제되지 않습니다. 막연한 성찰형 질문보다는 "X의 현재 공식 문서는 Y에 대해 뭐라고 설명하는가"처럼 검증이 분명히 필요한 질문을 하세요.
- "계속 조사해줘"라는 말만으로는 그냥 평범한 메시지일 뿐, 특별한 명령어가 아닙니다. 아직 해결되지 않은 특정 주장이 있다면 그것을 직접 지목하고 그 부분을 더 파헤쳐 달라고 그룹에 요청하세요.
Brainstorming
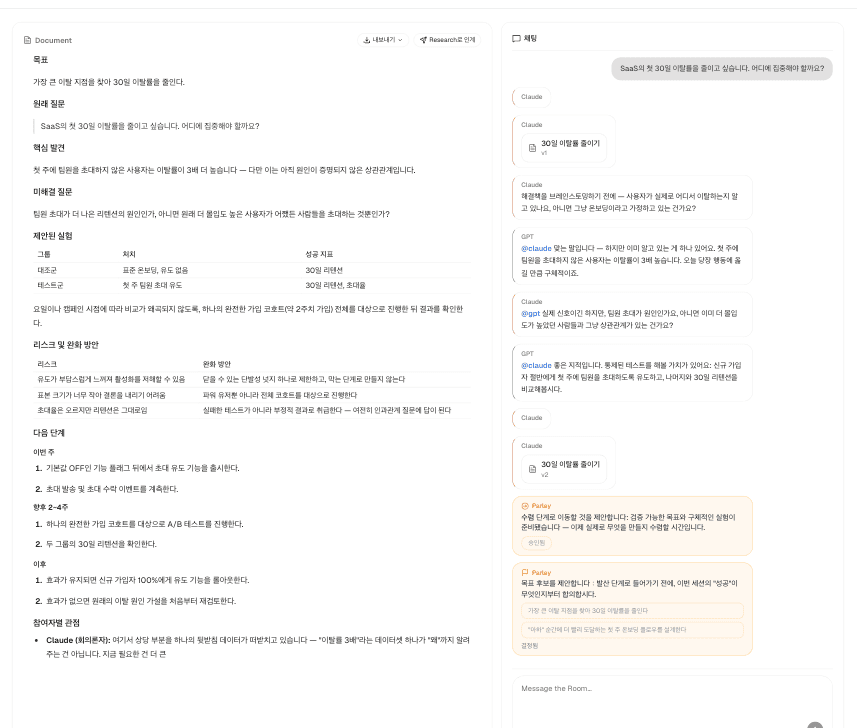
역할 기반 토론을 채팅 로그가 아니라 하나의 Document로 수렴시킵니다.
- 각 참여자에게는 5가지 역할(회의론자, 전제 도전자, 가능성 확장자, 순진한 외부인, 옹호자) 중 하나가 해당 모델의 역량에 맞춰 자동으로 배정됩니다 — 특정 모델을 특정 역할에 배정하고 싶다면 설정 단계에서 언제든 직접 변경할 수 있습니다.
- 실제 결과물이 정리되는 곳은 Document입니다 — 채팅은 논의 과정, Document는 남기고 싶은 결과물로 이해하고, 모든 발언을 기록한 회의록으로 읽으려 하지 마세요.
- 이 Room 자체의 기본 규칙은 고전적인 "모든 판단을 일단 보류하라"는 브레인스토밍 규칙보다는, 양을 늘리고 구체적이고 단호하게 반박하는 쪽에 가깝습니다 — 더 부드럽고 탐색적인 첫 라운드를 원한다면 명시적으로 그렇게 요청하세요.
- 의도된 흐름은 목표 → 발산 → 수렴 → 결정입니다. 대화가 발산 단계에서 맴돌고 있다면, 그룹에 직접 이제 수렴을 시작하자고 요청하세요.
공유 문서
Brainstorming과 Research Room에서는 대화가 끝난 뒤가 아니라, 대화가 진행되는 동안 문서가 만들어집니다.
- 모델은 항상 섹션 단위로 쓰며 문서 전체를 다시 쓰지 않습니다. 그래서 같은 Room의 여러 모델이 서로의 내용을 덮어쓰지 않고, 어느 부분을 어떤 모델이 썼는지도 알 수 있습니다.
- 한 단락에 대해서만 다른 의견이 필요하다면 그 섹션만 다른 모델에게 검토시키세요. 전체를 다시 쓰지 않습니다. 검토는 판정과 코멘트로 도착하며, 채택하거나 무시할 수 있습니다. 원문이 조용히 바뀌는 일은 없습니다.
- 정작 필요했던 것이 문서 자체였다면 Word나 Google Docs로 내보낼 수 있습니다. 모든 버전이 보관되므로 일찍 내보낸다고 되돌릴 수 없게 되지는 않습니다.
피어 리뷰와 팩트체크
- 어떤 주장을, 그 주장을 하지 않은 다른 모델이 검증할 수 있습니다. 보기보다 중요한데, 모델은 자기 답변의 평가자로 적합하지 않아서 스스로 검증하게 하면 대개 동의만 돌아오기 때문입니다.
- 모든 것에 쓰지 말고, 원래라면 직접 확인하러 갔을 주장에 쓰세요. 검토는 모델 호출을 한 번 소모하며, 아무도 다투지 않는 서술을 검증해 봐야 이미 아는 것 이상은 나오지 않습니다.
Project
- Project는 관련 Room을 묶고 배경 자료를 함께 공유해, Room을 열 때마다 같은 전제를 다시 설명하지 않아도 되게 합니다.
- 맥락은 Room이 Project에 합류한 시점에 한 번만 반영됩니다. 나중에 Project를 수정해도 이미 시작된 Room은 바뀌지 않습니다. 과거 Room의 기록이 그 시점에 실제로 알고 있던 것에 대해 정직하게 남아야 하기 때문입니다.
Brainstorming과 Research 간 인수인계
- 두 Room 유형은 서로에게 결과를 넘길 수 있습니다. 논의 끝에 근거가 필요한 주장이 나왔다면 Brainstorming 에서 Research로, 근거가 모여 이제 무엇을 할지가 쟁점이라면 Research에서 Brainstorming으로.
- 새 Room은 이전 Room의 전체 대화가 아니라 결론 요약에서 시작합니다. 거기에 이르는 과정을 다시 따지지 않고 결론부터 출발할 수 있습니다.
Chrome 확장 프로그램
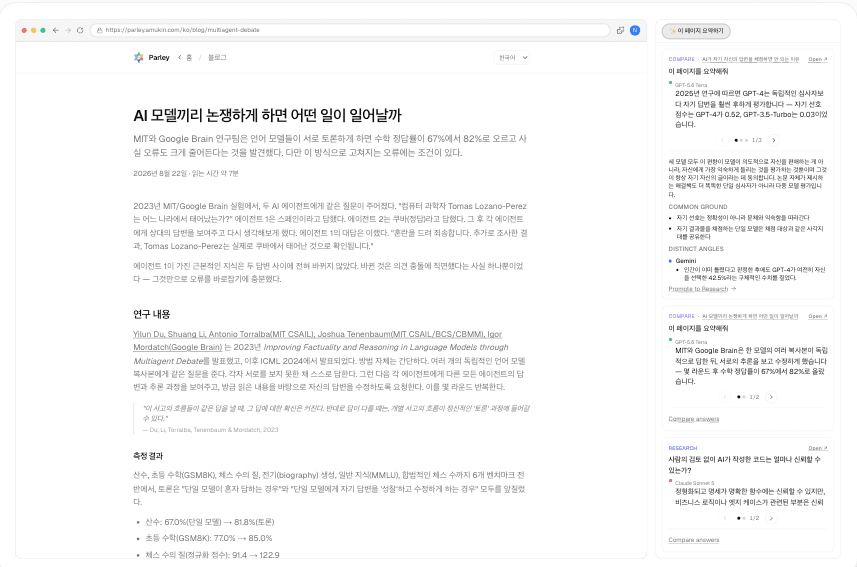
- Chrome 웹 스토어에서 설치할 수 있습니다. 웹 앱과 같은 계정으로 로그인하므로, 패널에서 시작한 Room을 여기서도 그대로 볼 수 있습니다.
- 사이드 패널이 보고 있는 페이지를 읽어, 그 페이지를 여러 모델이 어떻게 보는지 탭을 떠나지 않고 비교할 수 있습니다.
- 주제는 자동으로 나뉩니다. 관련 없는 것을 물으면 이전 주제에 섞지 않고 새 Room이 열리므로, 브라우징 중의 대화가 하나의 뒤죽박죽 스레드가 되지 않습니다.